Видео с ютуба Low-Bit Quantization
The myth of 1-bit LLMs | Quantization-Aware Training

Qwen3: Low-Bit Quantization & Performance

1-Bit LLM: The Most Efficient LLM Possible?

Как LLM выживают в условиях низкой точности | Основы квантования
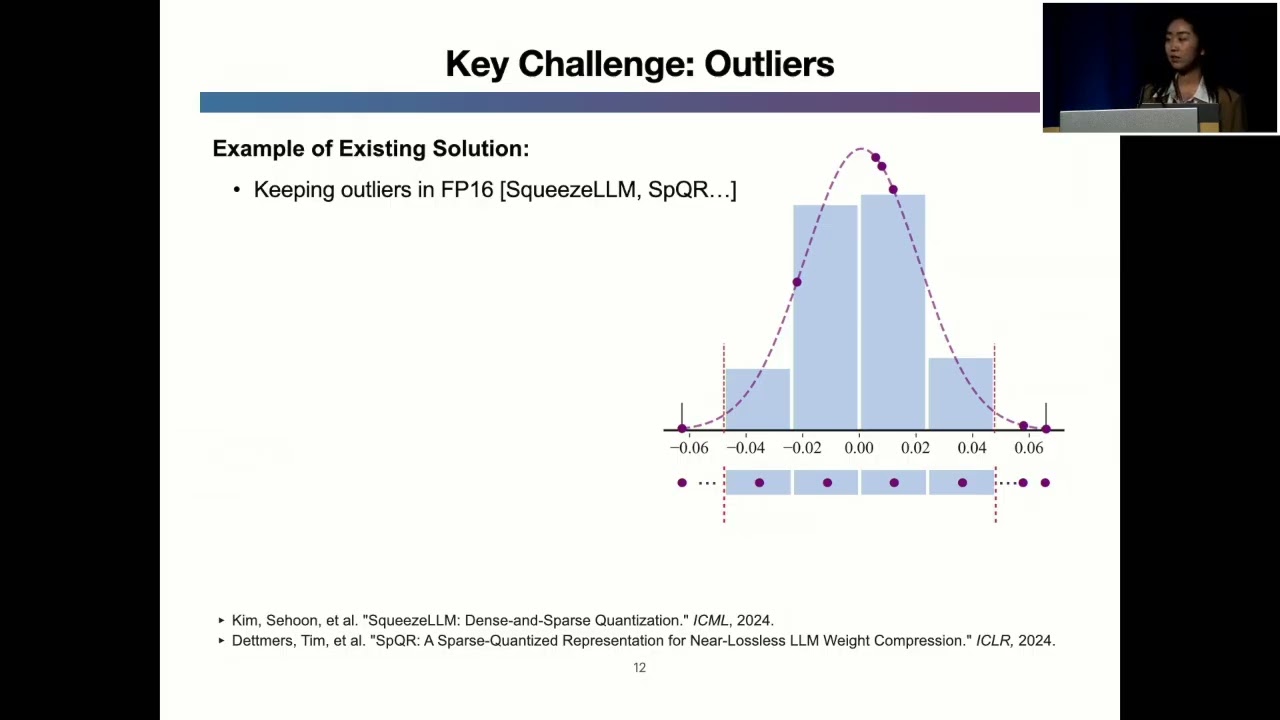
ICQuant: Index Coding enables Low-bit LLM Quantization

Лекция 118: GSQ-RCO: Улучшенная неравномерная квантование GGUF
Everything looks fine at 4-bit

OSDI '25 — DecDEC: Системный подход к развитию низкобитного квантования LLM

INT v.s. FP: A Comprehensive Study of Fine-Grained Low-bit Quantization Formats

Training models with only 4 bits | Fully-Quantized Training

Qwen3: Low-Bit Performance Study

Low-bit-width Large-model Quantization Challenge Live replay

GSQ-RCO: улучшенная неравномерная квантованная GGUF-модель

LittleBit: ультранизкобитное квантование с помощью латентной факторизации
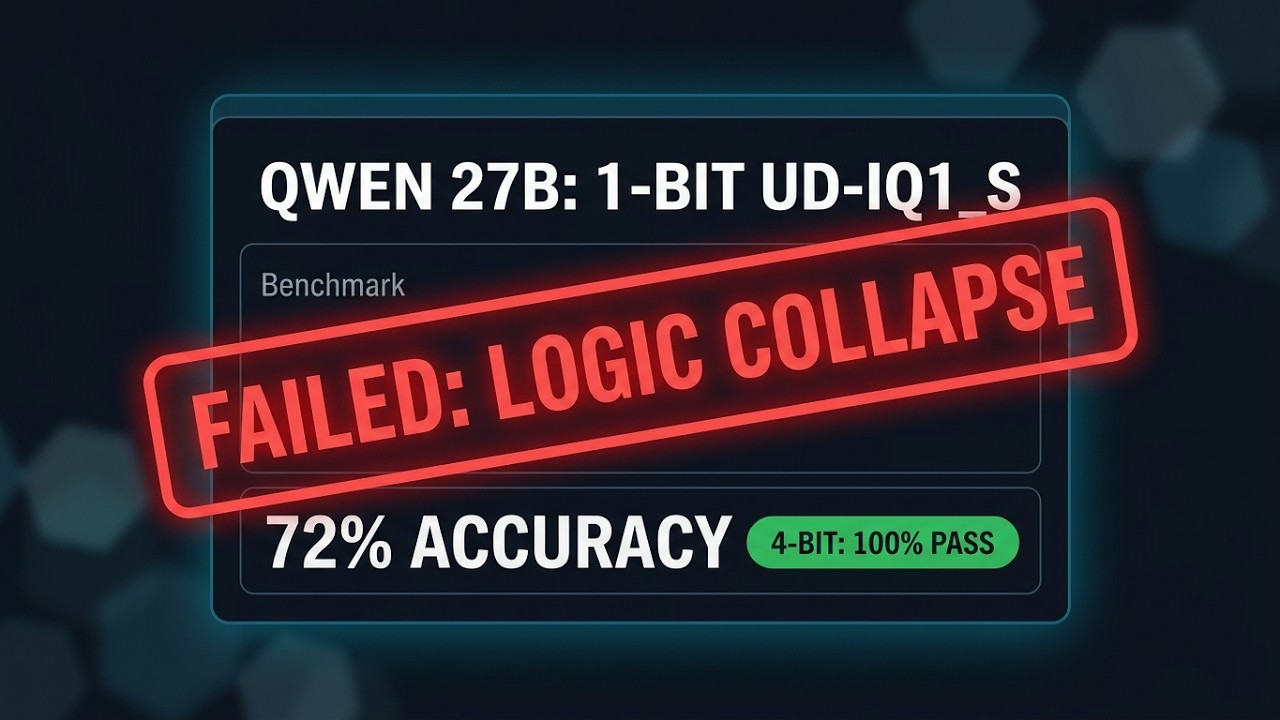
Does 1-Bit Quantization Destroy LLM Logic?

How Effective Are Low bit Quantized LLaMA3 Models? An Empirical Analysis

tinyML Asia 2021 Dongsoo Lee: Extremely low-bit quantization for Transformers

How to Achieve Extreme Low-bit Quantization for LLMs

How BitNet b1.58 Runs LLMs With Just 1.58-Bit Weights